算法
- 分类:C++ · 精通
- 更新时间: 2026-10-28
- 来源:4-算法.docx
- 高精度计算
在语言入门部分已经介绍乐几种数据类型,并且已经知道每种数据类型能够容纳的数字范围是有限的。一般情况下使用int类型,如果数字大一点还能使用long long类型。如果需要存储或者使用更大的整数该怎么办?不能使用浮点数,因为浮点数的有效数字位数也是有限的。有些编译器允许提供_int128类型,但是不仅大小依然局限(最多可以表示接近40位的十进制数),而且使用范围也很局限,不过可以使用数组来模拟非常长的整数。
—、高精度加法
高精度加法,其实就是竖式加法啦。也就是从最低位开始,将两个加数对应位置上的数码相加,并判断是否达到或超过10 。如果达到,那么处理进位:将更高一位的结果上增加1,当前位的结果减少10。
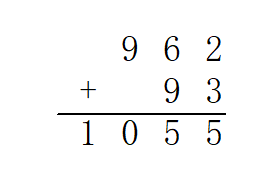
#include <iostream>
#include <cstring>
using namespace std;
const int MAXN = 10005;  // 数组长度
char num1[MAXN], num2[MAXN];  // 存储两个加数
int a[MAXN], b[MAXN], c[MAXN];  // 存储两个加数和它们的和
int main() {
	cin >> num1 >> num2;  // 输入两个加数
	int len1 = strlen(num1), len2 = strlen(num2);  // 计算两个加数的长度
	// 将字符串形式的加数转化为整型数组
	for (int i = 0; i < len1; i++) {
		a[i] = num1[len1 - i - 1] - '0';
	}
	for (int i = 0; i < len2; i++) {
		b[i] = num2[len2 - i - 1] - '0';
	}
	int len = max(len1, len2);  // 计算和的长度
	// 逐位相加
	for (int i = 0; i < len; i++) {
		c[i] += a[i] + b[i];
		if (c[i] >= 10) {
			c[i + 1]++;
			c[i] -= 10;
		}
	}
	// 处理最高位进位情况
	if (c[len] > 0) {
		len++;
	}
	// 输出结果
	for (int i = len - 1; i >= 0; i--) {
		cout << c[i];
	}
	cout << endl;
	return 0;
}
减法
高精度减法,也就是竖式减法啦。从个位起逐位相减,遇到负的情况则向上一位借1。整体思路与加法完全一致。
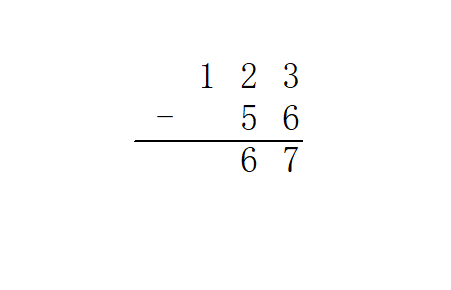
实例
#include <iostream>
#include <cstring>
using namespace std;
const int MAXN = 10005;  // 数组长度
char num1[MAXN], num2[MAXN];  // 存储被减数和减数
int a[MAXN], b[MAXN], c[MAXN];  // 存储被减数、减数和它们的差
int main() {
	cin >> num1 >> num2;  // 输入被减数和减数
	int len1 = strlen(num1), len2 = strlen(num2);  // 计算被减数和减数的长度
	// 将字符串形式的被减数和减数转化为整型数组
	for (int i = 0; i < len1; i++) {
		a[i] = num1[len1 - i - 1] - '0';
	}
	for (int i = 0; i < len2; i++) {
		b[i] = num2[len2 - i - 1] - '0';
	}
	int len = max(len1, len2);  // 计算差的长度
	// 逐位相减
	for (int i = 0; i < len; i++) {
		c[i] = a[i] - b[i];
		if (c[i] < 0) {
			c[i] += 10;
			a[i + 1]--;
		}
	}
	// 去除前导零
	while (len > 1 && c[len - 1] == 0) {
		len--;
	}
	// 输出结果
	for (int i = len - 1; i >= 0; i--) {
		cout << c[i];
	}
	cout << endl;
	return 0;
}
乘法
高精度乘法,类似加法,可以用竖式求乘法。在做乘法运算时,同样也有进位,同时对每一位进行乘法运算时,必须进行错位相加。
a3 a2 a1
b2 b1
c3 c2 c1
c4 c3 c2
c5 c4 c3
c6 c5 c4 c3 c2 c1
实例
#include<iostream>
#include<cstring>
#include<cstdio>
using namespace std;
int main(){
	char a1[100],b1[100];
	int a[100],b[100],c[100],lena,lenb,lenc,i,j,x;
	memset(a,0,sizeof(a));
	memset(b,0,sizeof(b));
	memset(c,0,sizeof(c));
	gets(a1);gets(b1);
	lena=strlen(a1);
	lenb=strlen(b1);
	for (i=0;i<=lena-1;i++)
		a[lena-i]=a1[i]-48;
	for (i=0;i<=lenb-1;i++)
		b[lenb-i]=b1[i]-48;
	for (i=1;i<=lena;i++) {
		x=0;                                  //用于存放进位
		for (j=1;j<=lenb;j++) {                //对乘数的每一位进行处理
			c[i+j-1]=a[i]*b[j]+x+c[i+j-1];     //当前乘积+上次乘积进位+原数
			x=c[i+j-1]/10;
			c[i+j-1] %= 10;
		}
		c[i+lenb]=x;                           //进位
	}
	lenc=lena+lenb;
	while (c[lenc]==0&&lenc>1)                 //删除前导零
		lenc--;
	for (i=lenc;i>=1;i--)
		cout<<c[i];
	cout<<endl;
	return 0;
}
除法
高精度除以低精度,做除法时,每一次商的值都在0~9,每次求得的余数连接以后的若干位得到新的被除数,继续做除法。因此,在做高精度除法时,要涉及到乘法运算和减法运算,还有移位处理。当然,为了程序简洁,可以避免高精度除法,用0~9次循环减法取代得到商的值。这里,我们讨论一下高精度数除以低精度数的结果,采取的方法是按位相除法。
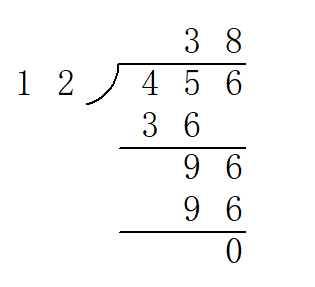
实例
#include<iostream>
#include<cstring>
#include<cstdio>
using namespace std;
int main() {
	char a1[100],c1[100];
	int a[100],c[100],lena,i,x=0,lenc,b;
	memset(a,0,sizeof(a));
	memset(c,0,sizeof(c));
	gets(a1);
	cin>>b;
	lena=strlen(a1);
	for (i=0;i<=lena-1;i++)
		a[i+1]=a1[i]-48;
	for (i=1;i<=lena;i++){             //按位相除
		c[i]=(x*10+a[i]) / b;
		x=(x*10+a[i]) % b;
	}
	lenc=1;
	while (c[lenc]==0&&lenc<lena)
		lenc++;                        // 删除前导 0
	for (i=lenc;i<=lena;i++)
		cout<<c[i];
	cout<<endl;
	return 0;
}
第二章 数据排序
信息获取后通常需要进行处理,处理后的信息其目的是便于人们的应用。信息处理方法有多种,通常有数据的排序、查找、插入等操作。
1.选择排序
(1)基本思想:每趟从待排序的数据元素中选出最小(或最大)的元素,顺序放在已排序的数列末尾,直到全部待排序的数据元素排完。
(2)排序过程:
初始数据元素 [49 38 65 97 76 13 27 49]
第一趟排序后 13 [38 65 97 76 49 27 49]
第二趟排序后 13 27 [65 97 76 49 38 49]
第三趟排序后 13 27 38 [97 76 49 65 49]
第四趟排序后 13 27 38 49 [76 97 65 49]
第五趟排序后 13 27 38 49 49 65 [97 76]
第六趟排序后 13 27 38 49 49 65 76 [97]
第七趟排序后 13 27 38 49 49 65 76 97
(3)算法描述:
选择排序很简单,它的大致处理流程为:
①从待排序序列中,找到关键字最小的元素;
②如果最小元素不是待排序序列的第一个元素,将其和第一个元素互换;
③从余下的 N - 1 个元素中,找出关键字最小的元素,重复(1)、(2)步,直到排序结束。
(4)算法分析:
最佳情况:T(n) = O(n2)
最差情况:T(n) = O(n2)
平均情况:T(n) = O(n2)
(5)代码实现:
void selectionSort(int a[],int n){
	int minIndex, temp;
	for (int i = 0; i < n - 1; i++){
		minIndex = i;
		for (int j = i + 1; j < n; j++){
			if (a[j] < a[minIndex]){
				minIndex = j;
			}
		}
		temp = a[i];
		a[i] = a[minIndex];
		a[minIndex] = temp;
	}
}
2.冒泡排序
(1)基本思想:冒泡排序重复地走访过要排序的数列,一次比较两个元素,如果它们的顺序错误就把它们交换过来。走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成。这个算法的名字由来是因为越小的元素会经由交换慢慢浮到数列的顶端。
(2)排序过程:
初始数据元素 [76 49 38 65 97]
第一趟排序: [49 76 38 65 97]
[49 38 76 65 97]
[49 38 65 76 97]
[49 38 65 76 97]
第二趟排序: [49 38 65 76] 97
[38 49 65 76] 97
[38 49 65 76] 97
[38 49 65 76] 97
第三趟排序: [38 49 65] 76 97
第四趟排序: [38 49] 65 76 97
排序结果: [38] 49 65 76 97
(3)算法描述:
①比较相邻的元素。如果第一个比第二个大,就交换它们两个;
②对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对,这样在最后的元素应该会是最大的数;
③针对所有的元素重复以上的步骤,除了最后一个;
④重复步骤1~3,直到排序完成。
(4)算法分析:
最佳情况:T(n) = O(n)
最差情况:T(n) = O(n2)
平均情况:T(n) = O(n2)
(5)代码实现
void bubbleSort(int a[], int n){
	for(int i=0 ; i<n-1; ++i){
		for(int j=0; j<n-i-1; ++j){
			if(a[j] > a[j+1]){
				int tmp = a[j];
				a[j] = a[j+1];
				a[j+1] = tmp;
			}
		}
	}
}
3.插入排序
(1)基本思想:每一趟将一个待排序的数据元素,按照其数值的大小插入到有序队列的合适位置里,直到全部插入完成。
(2)排序过程:
初始数据元素 [49 38 65 97 76 13 27 49]
第一趟排序后 [49] 38 65 97 76 13 27 49
第二趟排序后 [38 49] 65 97 76 13 27 49
第三趟排序后 [38 49 65] 97 76 13 27 49
第四趟排序后 [38 49 65 97] 76 13 27 49
第五趟排序后 [38 49 65 76 97] 13 27 49
第六趟排序后 [13 38 49 65 76 97] 27 49
第七趟排序后 [13 27 38 49 65 76 97] 49
第八趟排序后 [13 27 38 49 49 65 76 97]
(3)算法描述:
①从第一个元素开始,该元素可以认为已经被排序;
②取出下一个元素,在已经排序的元素序列中从后向前扫描;
③如果该元素(已排序)大于新元素,将该元素移到下一位置;
④重复步骤3,直到找到已排序的元素小于或者等于新元素的位置;
⑤将新元素插入到该位置后;
⑥重复步骤2~5。
(4)算法分析:
最佳情况:T(n) = O(n)
最差情况:T(n) = O(n2)
平均情况:T(n) = O(n2)
(5)代码实现
void insertSort(int a[], int n){
	for(int i=1; i<n; i++){
		if(a[i] < a[i-1]){
			int j= i-1;
			int x = a[i];
			a[i] = a[i-1];
			while(x < a[j]){
				a[j+1] = a[j];
				j--;
			}
			a[j+1] = x;
		}
	}
}
第三章 递推算法
递推法是一种重要的数学方法,在数学的各个领域中都有广泛的运用,也是计算机用于数值计算的一个重要算法。这种算法特点是:一个问题的求解需一系列的计算,在已知条件和所求问题之间总存在着某种相互联系的关系,在计算时,如果可以找到前后过程之间的数量关系(即递推式),那么,从问题出发逐步推到已知条件,此种方法叫逆推。无论顺推还是逆推,其关键是要找到递推式。这种处理问题的方法能使复杂运算化为若干步重复的简单运算,充分发挥出计算机擅长于重复处理的特点。
递推算法的首要问题是得到相邻的数据项间的关系(即递推关系)。递推算法避开了求
通项公式的麻烦,把一个复杂的问题的求解,分解成了连续的若干步简单运算。一般说来,可以将递推算法看成是一种特殊的迭代算法。
例3.1满足F1=F2=1,Fn=Fn-1+Fn-2的数列称为斐波那契数列(Fibonacci),它的前若干项是1,1,2,3,5,8,13,21,34……求此数列第n项(n>=3)。
即:f1=1 (n=1)
f2=1 (n=2)
fn=fn-1+fn-2 (n>=3)
程序如下:
#include<iostream>
using namespace std;
int main(){
	int f1=1,f2=1,f3;
	int n;
	cin>>n;
	for(int i=3;i<=n;++i){
		f3= f2+f1;
		f1 =f2;
		f2 =f3;
	}
	cout<<f3;
	return 0;
}
第四章 递归算法
递归(英语:Recursion),在数学和计算机科学中是指在函数的定义中使用函数自身的方法,在计算机科学中还额外指一种通过重复将问题分解为同类的子问题而解决问题的方法。
递归的基本思想是某个函数直接或者间接地调用自身,这样原问题的求解就转换为了许多性质相同但是规模更小的子问题。求解时只需要关注如何把原问题划分成符合条件的子问题,而不需要过分关注这个子问题是如何被解决的。
例4.1给定n(n>=1),用递归的方法计算1+2+3+4+…+( n-1) +n。
程序如下:
#include<iostream>
using namespace std;
int fac(int n){
	if (n==1)
		return 1;
	return (fac(n-1)+n);
}
int main(){
	int t;
	cin>>t;
	cout<<fac(t)<<endl;
	return 0;
}
第五章 搜索与回溯算法
搜索与回溯是计算机解题中常用的算法﹐很多问题无法根据某种确定的计算法则来求解,可以利用搜索与回溯的技术求解。回溯是搜索算法中的一种控制策略。它的基本思想是:为了求得问题的解,先选择某一种可能情况向前搜索,在探索过程中,一旦发现原来的选择是错误的,就退回一步重新选择,继续向前探索,如此反复进行,直至得到解或证明无解。
如迷宫问题:进入迷宫后,先随意选择一个前进方向,一步步向前试探前进,如果碰到死胡同,说明前进方向已无路可走。这时,首先看其他方向是否还有路可走:如果有路可走,则沿该方向再向前试探;如果已无路可走,则返回一步,再看其他方向是否还有路可走。按此原则不断搜索回溯再搜索,直到找到新的出路或从原路返回人口处无解为止。
递归回溯法算法框架[一]
int search(int k)
{
	for(i=1;i<=算符种数;i++)
		if (满足条件)
		{
			保存结果;
			if (到目的地) 输出解;
			else search(k+1);
			恢复:保存结果之前的状态(回溯一步)
		}
}
递归回溯法算法框架[二]
int search(int k)
{
	if (到目的地) 输出解;
	else
		for (i=1;i<=算符种数;i++)
			if (满足条件)
			{
				保存结果;
				search(k+1);
				恢复:保存结果之前的状态(回溯一步)
			}
}
例5.1素数环:1到20这20个数摆成一个环,要求相邻的两个数的和是一个素数。
【算法分析】
非常明显,这是一道回溯题目。将1开始,每个空位有20种可能,只要填进去的数合法:与左边相邻的数的和是一个素数。第20个数还要判断和第1个数的和是否素数。
【算法流程】
(1)数据初始化;(2)递归填数:判断第i个数填入是否合法。
①如果合法:填数;判断是否到达目标(20个已填完):是,打印结果;不是,递归填下一个;
②如果不合法:选择下一种可能。
【参考程序】
#include<cstdio>
#include<iostream>
#include<cstdlib>
#include<cmath>
using namespace std;
bool b[21]={0};
int total=0, a[21]={0};
void search(int);             //回溯过程
void print();                 //输出方案
bool pd(int,int);             //判断素数
int main(){
	search(1);
	cout<<total<<endl;        //输出总方案数
}
void search(int t){
	int i;
	for (i=1;i<=20;i++)                   //有20个数可选
		if (pd(a[t-1],i) && (!b[i]))      //判断与前一个数是否构成素数及该数是否可用
		{
			a[t]=i;
			b[i]=1;
			if (t==20) {
				if (pd(a[20],a[1]))
					print();
			}else
				search(t+1);
			b[i]=0;
		}
}
void print(){
	total++;
	cout<<"<"<<total<<">";
	for (int j=1;j<=20;j++)
		cout<<a[j]<<" ";
	cout<<endl;
}
bool pd(int x,int y){
	int k=2,i=x+y;
	while (k<=sqrt(i) && i%k!=0)
		k++;
	if (k>sqrt(i))
		return 1;
	else
		return 0;
}
第六章 贪心算法
一.基本概念
所谓贪心算法是指在对问题求解时,总是做出在当前看来最好的选择。也就是说,不从整体最优上加以考虑,他所做出的尽是在某种意义上的局部最优解。
贪心算法没有固定的算法框架,算法设计的关键是贪心策略的选择。必须注意的是,贪心算法不是对所有问题都能得到整体最优解,选择贪心策略必须具备无后效性,即某个状态以后的以后的过程不会影响以前的状态,只与当前状态有关。
所以对所采用的贪心策略一定要仔细分析其是否满足无后效性。
二、基本思路
1.建立数学模型来描述问题。
2.把求解的问题分成若干个子问题。
3.对每一子问题求解,得到子问题的局部最优解。
4.把子问题的解局部最优解合成原来解问题的一个解。
三、适用问题
贪心策略适用的前提是:局部最优策略能导致产生全局最优解。
四、实现框架
从问题的某一初始解出发;
while (能朝给定总目标前进一步)
{
	利用可行的决策,求出可行解的一个解元素;
}
所有解元素组合成问题的一个可行解;
五、贪心策略的选择
因为用贪心算法只能通过解局部最优解的策略来达到全局最优解,因此,一定要注意判断问题是否适合采用贪心算法策略,找到的解是否一定是问题的最优解。
例6.1 排队打水问题
有n个人排队到r个水龙头去打水,他们装满水桶的时间为t1,t2,…,tn为整数且各不相等,应如何安排他们的打水顺序才能使他们花费的时间最少(含等待时间)?
【输入样例】
4 2 //4人打水,2个水龙头
2 6 4 5 //每个人的打水时间
【输出样例】
23 //总共花费时间
【算法分析】
由于排队时,越靠前面的计算次数越多,因此越小的排在越前面得出的结果越小(可以用数学方法简单证明,这里就不再整述),所以这道题可以用贪心法解答,基本步骤为:
(1)将输入的时间按从小到大排序;
(2)将排序后的时间按顺序依次放入每个水龙头的队列中;
(3)统计,输出答案。
参考程序如下:
#include<iostream>
#include<cstring>
using namespace std;
int main(){
	int n,r,a[100],s[100];
	cin>>n>>r;
	for (int i=1;i<=n;i++){            //输入
		cin>>a[i];
	}
	for(int i=1 ; i<n; ++i)  {         //排序
		for(int j=1;j<=n-i-1;++j){
			if(a[j] > a[j+1]){
				int tmp = a[j] ;
				a[j] = a[j+1] ;
				a[j+1] = tmp;
			}
		}
	}
	memset(s,0,sizeof(s));             //初始化
	int j=0;
	int minx=0;
	for(int i=1;i<=n;i++){             //用贪心法求解
		j++;
		if (j==r+1)                    //前r个人为一组,第r+1个人回到第一个水龙头
			j=1;
		s[j]+=a[i];                    //加上等待时间
		minx+=s[j];
	}
	cout<<minx;                        //输出解答
}
第七章 分治算法
分治算法从字面上理解就是分而治之,即把一个复杂的问题分成两个或更多的相同或相似的子问题,再把子问题分成更小的子问题,直到最后的子问题可以简单地直接求解,原问题的解即子问题的解的合并。
1.分治算法的实现框架
对于一个规模为n 的问题,若该问题可以容易地解决(如规模n较小),则直接解决,否则将其分解为k个规模较小的子问题,这些子问题互相独立且与原问题形式相同,递归地解这些子问题,然后将各子问题的解合并,得到原问题的解。
{
	if (P <= n0)        //如果问题 P 的规模小于阈值 n0
	{
		resolve(P);     //解决这个问题
		return 0;
	}
	//将 P 分解为较小的子问题 P1,P2,…,Pk
	for(i=1;i<=k;i++)
		yi=Divide_and_Conquer(Pi);      //递归解决Pi
	T=MERGE(y1,y2,…,yk);                //合并子问题
	return T;
}
例7.1 求最大值
已知有n个整数存放在数组中,求这n个数中的最大值。
【算法分析】
利用分治法求解这个问题,算法分为两步:第一步,即采用二分法将问题分解成简单的子问题,分解成只有一个或两个元素的简单问题;第二步是治,即将简单的子问题逐步合并,就可以得到原问题的解。
参考程序如下:
#include<iostream>
using namespace std;
int max(int a[],int i,int j){
	int num1,num2;
	if (i==j)
		return a[i];
	else if (i==j-1)
		return a[i]>=a[j]?a[i]:a[j];
	else{
		int mid=(i+j)/2;
		num1=max(a,i,mid);
		num2=max(a,mid,j);
		return num1>num2?num1:num2;
	}
}
int main(){
	int n,a[100];
	cin>>n;
	for (int i=1;i<=n;i++){
		cin>>a[i];
	}
	cout<<max(a,1,n);
	return 0;
}
第八章 广度优先搜索算法
一、广度优先搜索的过程
广度优先搏索算法(又称宽度优先搜索)是最简便的图的搜索算法之一,这一算法也是很多重要的图的算法的原型。Dijkstra单源最短路径算法和Prim最小生成树算法都采用了和宽度优先搜索类似的思想。
广度优先算法的核心思想是:从初始节点开始,应用算符生成第一层节点,检查目标节点是否在这些后继节占中,若没有,再用产生式规则所有第一层的节点逐一展开,得到第二层节点,并逐一检查第二层节点钟是否包含目标节点,若没有,再用算符逐一展开第二层的所有节点…,如此依次扩展,检查下去,直到发现目标节点为止。即
1.从图中的某一顶点v0开始,先访问v0;
2.访问所有与v0相邻接的顶点v1,v2,…,vt;
3.依次访问与v1,v2,…,vt相邻接的所有未曾访问过的顶点
4.循此以往,直至所有的顶点都被访问过为止。
这种搜索的次序体现沿层次向横向扩展的趋势,所以称之为广度优先搜索。
二、广度优先搜索算法描述
int bfs(){
	初始化,初始状态存入队列;
	队列首指针head=0;尾指针tail=1;
	do
	{
		指针head后移一位,指向待扩展结点;
		for (int i=1;i<=max;++i)         //max为产生子结点的规则数
		{
			if (子结点符合条件)
			{
				tail指针增1,把新结点存入列尾;
				if (新结点与原已产生结点重复)
					删去该结点(取消入队,tail减1);
				else
					if (新结点是目标结点) 输出并退出;
			}
		}                                //队列为空
	}while(head<tail);
}
例8.1 马的遍历
有一个n*m的棋盘(1<n,m<=400),在某个点上有一个马,要求计算出马到达棋盘上任意一个点最少要走几步。
【输入样例】
3 3 1 1【输出样例】
0    3    2
3    -1   1
2    1    4
【算法分析】
广度优先搜索使用队列实现:先将初始状态加入到空的队列中,然后每次取出队首,找出队首所能转移到的状态,再将其压入队列;如此反复,直到队列为空。这样就能保证一个状态在被访问的时候一定是采用的最短路径。
参考程序如下:
#include<iostream>
#include<cstdio>
#include<cstring>
#include<algorithm>
#include<queue>
#include<cmath>
using namespace std;
const int dx[8]={-1,-2,-2,-1,1,2,2,1};
const int dy[8]={2,1,-1,-2,2,1,-1,-2};//8个方向
queue<pair<int,int> > q;
int f[500][500];//存步数
bool vis[500][500];//走没走过
int main()
{
	int n,m,x,y;
	memset(f,-1,sizeof(f));
	memset(vis,false,sizeof(vis));
	cin>>n>>m>>x>>y;
	f[x][y]=0;vis[x][y]=true;q.push(make_pair(x,y));
	while(!q.empty())
	{
		int xx=q.front().first,yy=q.front().second;q.pop();//取队首并出队
		for(int i=0;i<8;i++)
		{
			int u=xx+dx[i],v=yy+dy[i];
			if(u<1||u>n||v<1||v>m||vis[u][v])
				continue;//出界或走过就不走
			vis[u][v]=true;
			q.push(make_pair(u,v));
			f[u][v]=f[xx][yy]+1;
		}
	}
	for(int i=1;i<=n;i++){
		for(int j=1;j<=m;j++)
			printf("%-5d",f[i][j]);
		printf("\n");                    //注意场宽!!
	}
	return 0;
}
第九章 动态规划
动态规划程序设计是对解最优化问题的一种途径、一种方法,而不是一种特殊算法。不像前面所述的那些搜索或数值计算那样,具有一个标准的数学表达式和明确清晰的解题方法。动态规划程序设计往往是针对一种最优化问题,由于各种问题的性质不同,确定最优解的条件也互不相同.因而动态规划的设计方法对不同的问题,有各具特色的解题方法,而不存在一种万能的动态规划算法,可以解决各类最优化问题。
动态规划的基本思想与分治算法类似,也是将待求解的问题分解为若干个子问题(阶段),按顺序求解子阶段,前一子问题的解为后一子题的求解提供了有用的信息。在求解任一子问题时,列出各种可能的局部解,通过决策保留那些有可能达到最优的局部解,丢弃其他局部解。依次解决各子问题,最后一个子问题就是初始问题的解。
动态规划与分治算法最大的区别是:适合于用动态规划法求解的问题,经分解后得到的子问题往往不是互相独立的。
1.基本步骤
动态规划的基本步骤分为以下四步。
(1)化成子问题。对于动态规划,重要的是把一个大的问题划分成子问题进行问题降阶。通过逐级降阶将问题简单化,从而实现问题的解决。
(2)转移方程,把问题方程化。
(3)按照实际逻辑设置边界情况和初始条件
(4)确定计算顺序并计算求解。
例9.1乘积最大
设有一个长度为N的数字串,要求选手使用K个乘号将它分成K+1个部分,找出一种分法,使得这K+1个部分的乘积最大。
有一个数字串:312,当N=3,K=1时会有以下两种分法:
(1)3*12=36
(2)31*2=62
这时,符合题目要求的结果是:31*2=62
请设计一个程序,求得正确的答案。
【输入样例】
4 2
1231
【输出样例】
62【算法分析】
此题满足动太规划法的求解标准,我们把它按插入的乘号数来划分阶段,若插入k个乘号,可把问题看做k个阶段的决策问题。设f[i][k]表示在前i位数中插入k个乘号所得的最大值,a[j][i]表示从第j位到第i位所组成的自然数。用f[i][k]存储阶段k的每一个状态,可以得状态转移方程:
f[i][k]=max{f[j][k-1] * a[j+1][i]}(k<=j<i)
边界值:
f[j][0]=a[1][j](1<=j<=n)
根据状态转移方程,我们就很容易写出动态规划程序:
for (k=1;k<=k1;k++)              //k1为乘号个数
	for(i=k+1;i<=n;i++)
		for(j=k;j<i;j++)
			f[i][k]=max(f[i][k],f[j][k-1]*a[j+1][i]);
【参考程序】
#include<cstdio>
long long a[11][11],f[11][11];
long long s;
int n,i,k,k1,j;
int max(int a,int b){
	return a>b?a:b;
}
int main(){
	scanf("%d%d", &n, &k1);
	scanf("%lld" , &s);
	for(i=n;i>=1;i--){
		a[i][i]=s%10;
		s/=10;
	}
	for(i=2;i<=n;i++)
		for(j=i-1;j>=1;j--)
			a[j][i]=a[j][i-1]*10+a[i][i];
	for(i=1;i<=n;i++)                //预处理不加乘号的情况
		f[i][0]=a[1][i];
	for (k=1;k<=k1;k++)
		for(i=k+1;i<=n;i++)
			for(j=k;j<i;j++)
				f[i][k]=max(f[i][k],f[j][k-1]*a[j+1][i]);
	printf("%lld\n",f[n][k1]);
	return 0;
}