数据结构
- 分类:C++ · 进阶
- 更新时间: 2026-10-23
- 来源:3-数据结构.docx
- 栈
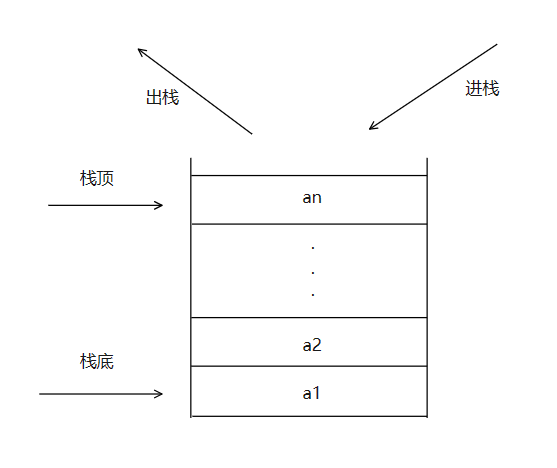
栈是一种操作受限的线性表,它只能在某一端插入和删除,比如说向纸箱中放书,放的时候只能一本一本的往上堆叠,而取走时只能从上面一本一本的取。堆和取都是在顶部进行,底部一般是不动的。
在这里人们一般将进行插入和删除的一端成为栈顶,另一端称之为栈底。插入一般称为进栈(PUSH),删除则称为退栈(POP)。栈也可以叫做后进先出表(LIFO表)。
一个栈可以用定长为n的数组s来表示,用一个栈指针top指向栈顶。若top=0,表示栈空,top=n时栈满。进栈时top加1,退栈时top减1.当top<0时为下溢。栈指针在运算时永远指向栈顶。
1.进栈(PUSH)算法
步骤一:若 top>=n时,则给出溢出信息,作出错处理(进栈前首先检查栈是否已满,满则溢出不满则作步骤二)
步骤二:top++(栈指针加一,指向进栈地址)
步骤三:s[top]=x,结束(x为新进栈的元素)
2.退栈(POP)算法
步骤一:若top<=0,则给出下溢信息,作出错处理(退栈前先检查是否为空栈,空则下溢,不空则作步骤二)
步骤二:x=s[top],(退栈后元素赋给x)
步骤三:top--,结束(栈指针减一,指向栈顶)
进栈、出栈的C++实现过程:
#define n 100
void push(int s[],int *top,int *x)  //入栈
{
	if(top == n) printf("overflow");
	else
	{
		(*top)++;
		s[*top] = *x;
	}
}
#define n 100
void pop(int s[],int *top,int *y)  //出栈
{
	if (*top == 0) printf("underflow");
	else
	{
		*y = s[*top];
		(*top)--;
	}
}
对于出栈的下溢,程序中仅仅给出了一个标志信息,而在实际应用中,下溢可用来作为控制程序转移的判断标志,十分的有用。对于入栈运算中的上溢,则是一种致命的错误,将使程序无法运行,所以要设法避免。
堆栈的数组模拟
十进制数n和其他d进制数的转换是实现计算的基本问题,解决办法很多,下面给出一种算法原理:n=(n/d)*d+n%d(其中/为整除运算,%为求余运算)。
代码如下:
#include <cstdlib>
#include<iostream>
using namespace std;
#define size 100
//a数组用于记录余数,n是十进制数,d是转换成d进制
int a[size+1],n,d,i=0,j;
main(){
	cout <<"Please enter a number(N) base 10:";cin>>n;
	cout <<"Please enter a number(d):";cin>>d;
	do{
		a[++i] = n%d;
		n = n/d;
	}while(n!= 0);
	for(j=i;j>0;j--){
		cout<<a[j];
	}
	return 0;
}
火车站列车调度示意图如下所示,假设调度站两侧的
轨道为单向行驶轨道。
- 如果进栈车厢序列为123,则可能出栈的序列是什么?
- 如果进站的车厢序列为123456,问能否得到135426和435612的出站序列?
分析第一题:假设1第一个出站,有123,132两种情况,假设2第一个出站,有213,231两种情况,假设3第一个出站,有321一种情况。
分析第二题:135426序列是可行的,435612的问题出在1先出站,2压在栈顶1不可能先出站。
例题1.1 括号的匹配
假设一个表达式由英文字母(小写)、运算符(+、-、*、/)和左右小括号构成,以“@”作为表达式的结束符。请编写一个程序检查表达式中的左右圆括号是否匹配,若匹配,则返回“YES”,否则返回“NO”。假设表达式长度小于255,左圆括号小于20个。
算法分析:假设输入的字符串存储在c中(char c[256])。我们可以定义一个栈:char s[maxn+1]; int top;用它来存放表达式中从左往右的左圆括号(maxn=20)。
顺序(从左往右)扫描表达式的每个字符c[i],若是“(”,则让它进栈,若遇到的是“)”,则让栈顶元素出栈,当栈发生下溢或当表达式处理完毕但栈非空时,表示不匹配,返回“NO”;否则表示匹配,返回“YES”。
#include <cstdio>
#include <cstdlib>
#define maxn 20
using namespace std;
char c[256];
bool judge(char c[256]){
	int top=0,i=0;
	while(c[i] != '@'){
		if(c[i]=='(') top++;
		if(c[i]==')'){
			if (top>0) top--;
			else return 0;
		}
	i++;
}
if(top != 0) return 0;
else return 1;
}
main(){
	scanf("%s",c);
	if (judge(c)) printf("YES");
	else printf("NO");
	return 0;
}
第二章 队列
队列是一种限定在一端进行插入,另一端进行删除的操作受限的特殊线性表,就像排队买东西,排在前面的人买完东西后离开队伍,而后来的人总是排在队伍的末位。通常把删除和插入操作称为出队和入队。允许出队的一端叫对头,允许入队的一端叫队尾。所有要出入的数据项只能从队尾进入从对头出去。这种表也被叫做先进先出表(FIFO)。
队列可以用数组Q[m+1]来存储,数组的上界m就是队列的最大容量。在队列的运算中需要设计两个指针:head(队头指针),实际指向队头元素的前一个位置,tail(队尾指针),指向队尾元素所在位置。一般情况下,两个指针的初始值设置为0,这时队列为空,没有元素。下图2-1画出了由六个元素构成的队列,数组定义Q[12]。
图2-1由六个元素构成的队列
Q(i) i=3,4,5,6,7,8,头指针head=2,尾指针tail=8。
队列中拥有元素的个数为:L=tail-head。现要让排头的元素出队,则需要将头指针加一,即head++。这时头指针向上移动一个位置,指向Q(3),表示Q(3)以出队。见图2-2。
图2-2 头指针加一Q(3)出队
如果想让一个新元素入队,则需尾指针向上移动一个位置,即tail++,这时Q(9)入队,见图2-3。
图2-3 尾指针加一,使Q(9)入队
当队尾已经处理在最上面时,即tail=10,见图2-4,如果还要执行入队操作,则要发生上溢,但实际上队列中还有三个空位置,所以我们称这种溢出为假溢出。
克服假溢出的方法有两种。一种是将队列中的所有元素向低地址区移动,如果队列很长的话,显然这种方法很浪费时间;另一种方法是将数组的存储区看作是一个首尾相连的环形区域。当存放到n地址后,下一个地址就翻转为1.在结构上采用这种技巧来存储的队列称为循环队列。见图2-5。
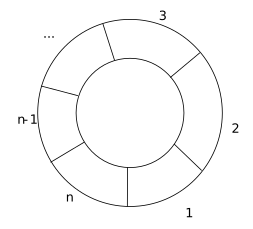
图2-5 循环队列
循环队列的入队算法如下:
1.tail++;
2.若tail=n+1,则tail=1;
3.若head=tail,尾指针与头指针重合了,表示元素已经装满队列,则作上溢出错处理。
4.否则,Q(tail)=x,结束(x为新入队元素)。
与线性表一样,栈和队列可以采用链表存储结构,当要实现多个栈共享内存或多个队共享内存时,选择链式分配更为合适。
例2.1 假设在周末舞会上,男士们和女士们进入舞厅时,各自排成一队。跳舞开始时,依次从男队和女队的队头上各出一人配成舞伴。规定每个舞曲只有一对跳舞者。若两队初始人数不相同,则较长的哪一队中未配对的人等待下一轮舞曲。现在要求写一个程序,模拟上述舞伴配队问题。
[输入]
第一行两队的人数
第二行舞曲的数目
#include <iostream>
#include <cstdio>
using namespace std;
int men[10001],women[10001];
int head1=1,tail1,head2=1,tail2,song=1,songs;
int main(){
	//输入两队的人数,并将他们遍历到数组当中去
	int m,n;
	cout<<"输入两队的人数"<<endl;
	cin>>m>>n;
	for(int i=1;i<=m;i++) men[i]=i;
	for(int i=1;i<=n;i++) women[i]=i;
	//输入舞曲的数目,记录下来
	cout<<"输入舞曲的数目"<<endl;
	cin>>songs;
	//把队1和队2的长度赋值给tail1和tail2存起来
	tail1=m;tail2=n;
	while(song>=songs){
		tail1++;men[tail1]=men[head1];head1++;
		tail2++;women[tail2]=women[head2];head2++;
		song++;
	}
return 0;
}
第三章 链表
第一节 顺序表
顺序表是用一段物理地址连续的存储单元依次存储数据元素的线性结构,一般情况下采用数组存储。在数组上完成数据的增删查改。
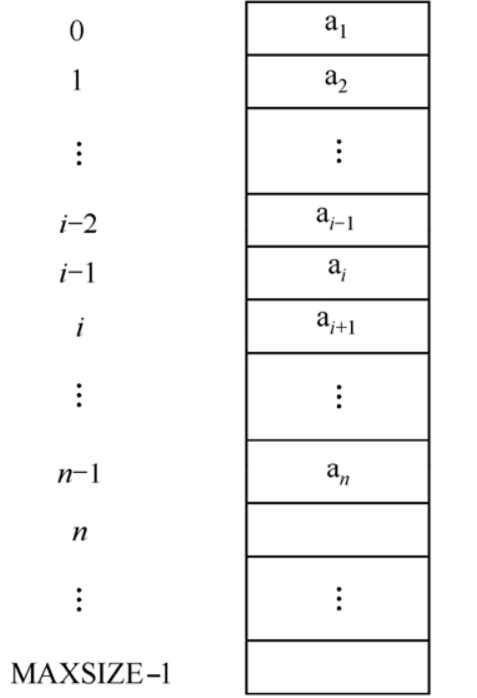
1.地址计算:Loc(ai)=Loc(a1)+(i-1)*k,Loc(ai+1)=Loc(ai)+k。
2.特点:逻辑上相邻的元素在物理上也相邻。
3.优点:只需要存放数据元素自身的信息,存储密度大,空间利用率高,存取速度快。
4.缺点:需要事先分配存储空间,容易造成空间浪费,插入删除操作时效率低。
第二节 链表
链表是一种物理存储单元上非连续、非顺序的存储结构,数据元素的逻辑顺序是通过链表中的指针链接次序实现的。链表由一系列结点(链表中每一个元素称为结点)组成,结点可以在运行时动态生成。每个结点包括两个部分:一个是存储数据元素的数据域,另一个是存储下一个结点地址的指针域。 相比于线性表顺序结构,操作复杂。由于不必须按顺序存储,链表在插入的时候可以达到O(1)的复杂度,比另一种线性表顺序表快得多,但是查找一个节点或者访问特定编号的节点则需要O(n)的时间,而线性表和顺序表相应的时间复杂度分别是O(logn)和O(1)。
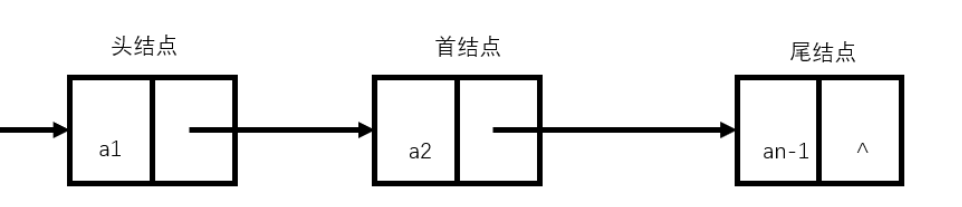
1.单向链表/顺序链表
单链表是一种链式存取的数据结构,用一组地址任意的存储单元存放线性表中的数据元素。链表中的数据是以结点来表示的,每个结点的构成:元素(数据元素的映象) + 指针(指示后继元素存储位置),元素就是存储数据的存储单元,指针就是连接每个结点的地址数据。
2.双向链表
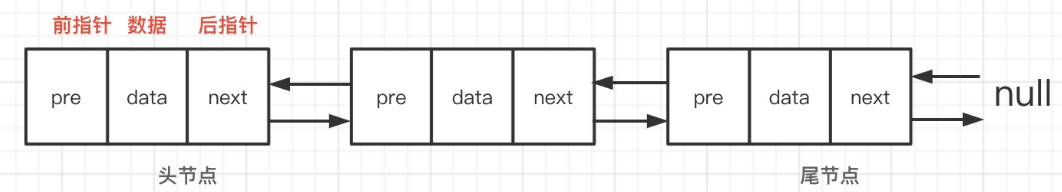
双向链表也叫双链表,是链表的一种,它的每个数据结点中都有两个指针,分别指向直接后继和直接前驱。所以,从双向链表中的任意一个结点开始,都可以很方便地访问它的前驱结点和后继结点。一般我们都构造双向循环链表。
3.循环链表
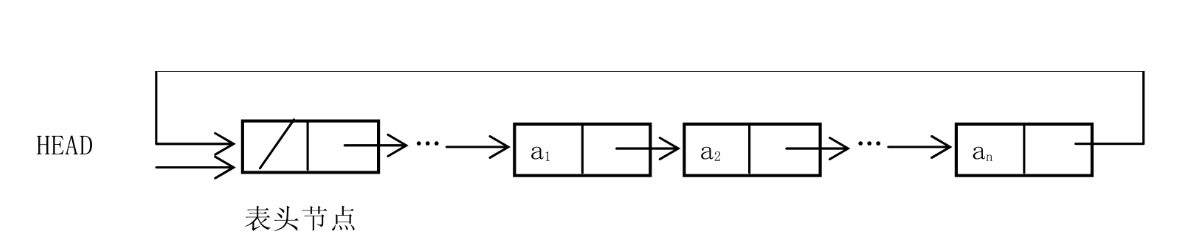
循环链表是另一种形式的链式存储结构。它的特点是表中最后一个结点的指针域指向头结点,整个链表形成一个环。
例题2.1 线性表若采用链表存储结构,要求内存中可用存储地址(D)。
A.必须连续 B.部分地址连续 C.一定不连续 D.连续不连续均可
分析:数组存储单元地址要连续,而链表可以在产生新节点时动态申请内存,所有连不连续都可以。
第四章 树
树是一种非线性数据结构,用它能很好地描述有分支和层次特性的数据集合。树形结构在现实世界中也有广泛应用,如社会组织机构的组织关系图就可以用树形结构来表示。树在计算机领域中也有广泛应用,如在编译系统中,用树表示源程序的语法结构。
在树形结构中,二叉树是最常用的结构,它的分支个数确定,又可以为空,并有良好的递归特性,特别适宜于程序设计,因此也常常将一般树转换成二叉树形式进行处理。
- 树的概念
一棵树是由n个结点组成的集合,其中:每个元素称为结点,有一个特定的结点,称为根节点或者树根,除了根节点外,其余结点能分成m(m>=0)个互不相交的有限集合T0,T1,....,Tm-1。其中的每个子集又都是一棵树。这些集合称为树的子树。如图3-1。
图 3-1 一棵树
树的基本概念:
(1)树是递归定义的。
(2)一棵树中至少要有一个节点。这个节点就是根节点,他没有前驱,其余每个节点都有唯一的一个前驱结点。每个节点可以有0或多个后续节点。因此树虽然是非线性结构,但也是有序结构。
(3)一个结点子树的个数,称之为这个结点的度(degree,结点1的度为3,结点3的度为0),度为0的结点叫做叶节点,度不为0的结点称为分支结点,根以外的结点又被称为内部节点;树中各结点的度的最大值称为这棵树的度。
(4)在用图形表示的树型结构中,对两个用线段(称为树枝)连接的相关联的结点,称上端结点为下端结点的父结点,称下端结点为上端结点的子结点。称同一个父结点的多个子结点为兄弟结点。如结点1是结点2、3、4的父结点,结点2、3、4是结点1的子结点,它们又是兄弟结点,同时结点2又是结点5、6的父结点。称从根结点到某个子结点所经过的所有结点为这个子结点的祖先。如结点1、4、7是结点8的祖先。称以某个结点为根的子树中的任一结点都是该结点的子孙。如结点7、8、9都是结点4的子孙。
(5)定义一棵树的根结点的层次(level)为0,其他结点的层次等于它的父结点层次加1。如结点2、3、4的层次为1,结点5、6、7的层次为2,结点8、9的层次为3。一棵树中所有的结点的层次的最大值称为树的深度(depth)。如这棵树的深度为3。
(6)对于树中任意两个不同的结点,如果从一个结点出发,自上而下沿着树中连着结点的线段能到达另一结点,称它们之间存在着一条路径。可用路径所经过的结点序列表示路径,路径的长度等于路径上的结点个数减1。如图3-1中,结点1和结点8之间存在着一条路径,并可用(1、4、7、8)表示这条路径,该条路径的长度为3。注意,不同子树上的结点之间不存在路径,从根结点出发,到树中的其余结点一定存在着一条路径。
(7)森林(forest)是m(m>=0)棵互不相交的树的集合。
树的存储结构:
方法一:数组,又叫做“父亲表示法”。
优缺点:利用了树中除了根节点以外每个节点都有唯一父节点的性质,很容易找到树的根,但是找孩子时要遍历整个线性表。
方法二:树型单链表结构,称为孩子表示法
优缺点:只能从父节点遍历到子节点,不能从子节点返回到父节点。但程序中确实需要从某个节点返回到它的父节点时,就需要在结点中多定义一个指针变量存放父节点的信息,这种结构又叫带逆序的树型结构。
方法三:树型双链表结构,称为“父亲孩子表示法”。每个结点包括一个数据域和两个指针域(一个指向若干子结点,一个指向父结点)。
方法四:二叉树型表示法,称为“孩子兄弟表示法”。它是一种双链表结构,但每个结点包括一个数据域和两个指针域(一个指向该结点的第一个孩子结点,一个指向该结点的下一个兄弟结点)。
树的遍历:
A.先序(根)遍历:先访问根结点,再从左到右按照先序思想遍历各棵子树。如图3-2先序遍历的结果为:12453678;
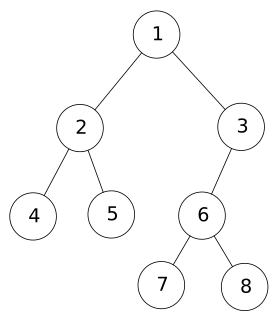
图3-2
B.后序(根)遍历:先从左到右遍历各棵子树,再访问根结点。如图3-2后序遍历的结果为:45278631;
C.中序(根)遍历:先遍历左子树,然后访问根结点,再遍历右子树。如图3-2中序遍历的结果为:42517683;
D.层次遍历:按层次从小到大逐个访问,同一层次按照从左到右的次序。如图3-2层级遍历的结果为:12345678;
大家可以看出,A、B、C两种方法的定义是递归的,所以在程序实现时往往也是采用递归的思想,即通常所说的“深度优先搜索”。
D方法应用也较多,实际上是我们讲的“广度优先搜索”。思想如下:若某个结点被访问,则该结点的子结点应记录,等待被访问。顺序访问各层次上结点,直至不再有未访问过的结点。为此,引入一个队列来存储等待访问的子结点,设一个队首和队尾指针分别表示出队、进队的下标。
例4.1 一棵树的(A)第一个访问结点是根节点。
A.先序遍历B.中序遍历C.后序遍历D.以上都是
分析:先序遍历时顺序为根左右,中序遍历时顺序为左根右,后序遍历时顺序为左右根。
- 二叉树
二叉树基本概念:
二叉树(binary tree,简写成 BT)是一种特殊的树型结构,它的度数为2的树。即二叉
树的每个结点最多有两个子结点。每个结点的子结点分别称为左孩子、右孩子,它的两棵子树分别称为左子树、右子树。二叉树有5种基本形态(如图3-3):
图3-3
前面引人的树的术语也基本适用于二叉树,但二叉树与树也有很多不同,如:二叉树的每个结点至多只能有两个子结点,二叉树可以为空,二叉树一定是有序的,通过它的左、右子树关系体现出来。
二叉树的性质:
【性质1】在二叉树的第i层上最多有2i-1个结点(i>=1)。
【性质2】深度为k的二又树至多有2k-1个结点(k>-1)。
特别:一棵深度为k且有2-1个结点的二又树称为满二文树,如图3-4为深度为4的满二叉树,这种树的特点是每层上的结点数都是最大结点数。
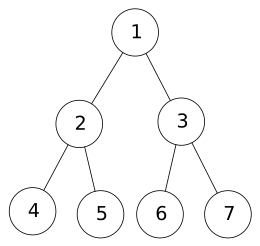
图3-4
可以对满二叉树的结点进行连续编号,约定编号从根结点起,自上而下,从左到右,由此引出完全二叉树的定义,深度为k,有n个结点的二叉树当且仅当其每一个结点都与深度为k的满二又树中编号从1到n的结点一一对应时,称为完全二叉树。
图3-5就是一个深度为3,结点数为6的完全二叉树。它有如下特征:叶结点只可能
在层次最大的两层上出现:对任一结点,若其右分支下的子孙的最大层次为m,则在其左分支下的子孙的最大层次必为m或m+1。
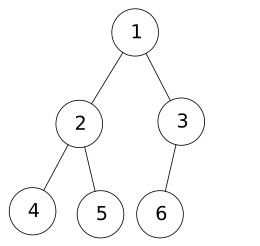
图3-5
【性质3】对任意一棵二叉树,如果其叶结点数为n0,度为2的结点数为n2,则一定满足:n0=n2+1。
【性质4】具有n个结点的完全二叉树的深度为floor(log2")+1。
【性质5】对于一棵n个结点的完全二叉树,对任一个结点(编号为i),有:
①如果i=1,则结点i为根,无父结点;如果i>1,则其父结点编号为i/2。
如果2*i>n则结点i无左孩子(当然也无右孩子,为什么?即结点i为叶结点);否则左孩子编号为
②如果2*i+1>n,则结点i无右孩子;否则右孩子编号为2*i+1。
二叉树的存储结构:
用单链表或者双链表存储二叉树叫做链式存储结构。
用几个数组加上一个指针变脸组成的顺序存储结构。
二叉树的遍历:
所谓的遍历是按照一定的规律和次序访问树中的各个结点,而且每个结点仅被访问一次。遍历二叉树的四种方法:前序遍历、中序遍历、后序遍历、层次遍历。
(1)先序遍历:先访问根节点,在访问左子树,最后访问右子树
(2)中序遍历:先左子树,再根节点,最后右子树。
(3)后序遍历:先左子树,后右子树,最后根节点。
(4)层次遍历:每一层从左往右访问每一个结点。
关于我们前面讲的表达式数,我们可以分别用先序、中序、后序的遍历方法得出完全不一样的遍历结果,遍历结果如下,正好对应着表达式的3种表示方法。
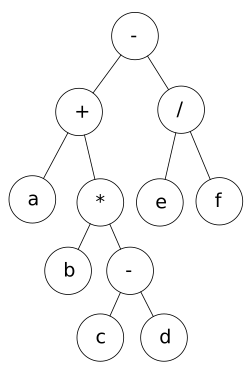
用上述的遍历方法遍历如上图的二叉树(a+b*(c-d)-e/f),前缀表示为:-+a*b-cd/ef。中缀表达式为:a+b*c-d-e/f。后缀表达式为:abcd-*+ef/-。
例题4.2 如果根节点的深度记为1,则一棵恰有2011个叶节点的二叉树的深度最少是(C)。
A.10 B.11 C.12 D.13
分析:由公式n=2n0-1得出总结点数是4021,深度公式是2K-1,因为211-1<4021且212-1>4021,
所以是12层。
第五章 图论算法
第一节 基本概念
图是一种复杂的非线性结构。在人工智能、工程、数学、物理、化学、生物和计算机科学领域中,图结构有着广泛的应用。
什么叫做图呢?点用边连起来就叫做图,严格意义上来讲,图是一种数据结构,定义为:graph=(V,E)。V是一个非空有限集合,代表顶点(结点),E代表边的集合。
图的相关概念:
1.有向图:图的边有方向,只能按箭头方向从点到另点。 (a)就是一个有向图。
2.无向图:图的边没有方向,可以双向。(b)就是一个无向图。
3.结点的度:无向图中与结点相连的边的数目,称为结点的度。
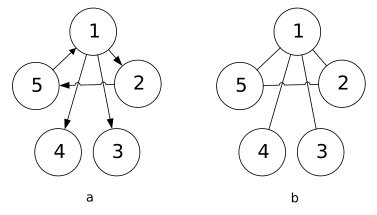
4.结点的入度:在有向图中,以这个结点为终点的有向边的数目。
5.结点的出度:在有向图中,以这个结点为起点的有向边的数目。
6.权值:边的“费用",可以形象地理解为边的长度。
7.连通:如果图中结点U,V之间存在一.条从U通过若干条边、点到达V的通路,则称J.V是连通的。
8.回路:起点和终点相同的路径称为回路或“环”。
9.完全图:一个n阶的完全无向图含有n*(n 1)/2条边;一个n阶的完全有向图含有* (n-1)条边。
10.稠密图:一个边数接近完全图的图。
11.稀疏图:一个边数远远少于完全图的图。
12.强连通分量:有向图中任意两点都连通的最大子图。下图中,1-2-5构成一个强连通分量。特殊地,单个点也算一个强连通分量所右图有三个强连通分量:1-2-5,4,3。
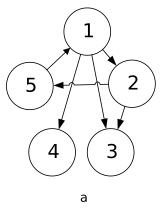
图的存储结构:图的存储结构主要分为两种:
1.二维数组邻接矩阵存储
图的邻接矩阵存储方式是用一个二维数组(称邻接矩阵)存储图中的边或弧的信息。它用于稠密图。
例如图结构4-3对应的邻接矩阵为图4-4。
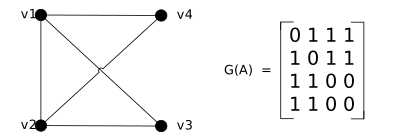
图4-3 图4-4
再例如图结构4-5对应的邻接矩阵为图4-6。
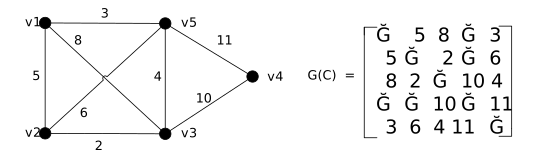 图4-3 图4-4
2.邻接表存储结构
邻接表是一种将数组与链表相结合的存储方法,其具体体现为:将图中顶点用一个一维数组存储,每个顶点Vi的所有邻接点用一个单链表来存储,链表中存放于当前结点相邻的结点在数组中的下标,适用于稀疏图。
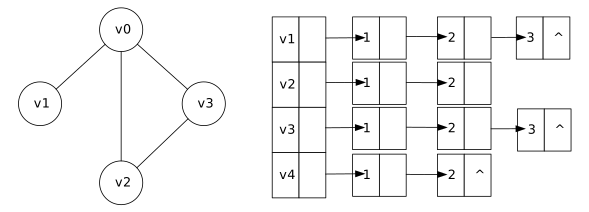
例题:5.1 6个顶点的连通图的最小生成树,其边数为(B)。
A.6 B.5 C.7 D.4
分析:最小生成树包含原图的所有节点而只用最少的边和最小的权值距离,因为n个节点最少需要n-1个边联通,而距离就需要采用某种策略选择恰当的边。所以选B
第二节 图的遍历
从图4.6中某一顶点出发系统的地访问图中所有顶点,使每个顶点恰好被访问一次,这种运算操作被称为图的遍历。为了避免重复访问某个顶点,可以设一个标志数组visited[i],未访问时值为false,访问一次后改为true。图的遍历分为深度优先遍历和广度优先遍历两种方式,两者的时间效率都是O(n*n)。
深度优先遍历:
深度优先遍历与深度优先搜索类似,从一个点A出发,将这个点标为已访问visited[i]=true,然后再访问所有与之相连且未被访问过的点。当A的所有邻接点都被访问过后,退回到A的上一个点(假设是B),再从B的另一个未被访问的邻接点出发。
例如对右边的这个无向图深度优先遍历,假定先从1出发。程序按如下顺序遍历:
A.1->2->5,然后退回到2,退回到1。
B.从1开始访问未被访问过的点3,3并没有访问过得邻接点,退回1。
C.再从1开始访问未被访问过的点4,再退回1。
D.起点所有的邻接点都已被访问,遍历结束。
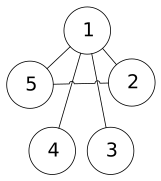
图4.6
广度优先遍历:
广度优先遍历并不常用,从编程的复杂度角度考虑,通常采用的是深度优先遍历。
广度优先遍历和广度优先搜索相似,因此使用广度优先遍历一张图并不需要掌握新的知识,在原有的广度优先搜索的基础上,做一些小的修改,就变成了广度优先算法。
例题5.2 具有n个顶点,e条边的图采用邻接表存储结构,进行深度优先遍历和广度优先遍历运算的时间复杂度均为(D)。
- O(n2) B.O(e2) C.O(ne) D.O(n+e)
分析:用邻接表存储时,遍历整张图的时间复杂度是O(n+e)。
第三节 一笔画问题
如果一个图存在一笔画,则一笔画的路径叫做欧拉路,如果最后又回到起点,那这个路径叫做欧拉回路。
定义奇点跟这个点相连的边数目有奇数个的点。对于能够一笔画完的图,有以下两个定理。
定理一:存在欧拉路的条件,图是联通的,且只有两个奇点。
定理二:存在欧拉回路的条件,图是连通的,且有0个奇点。
两个定理的正确性都是显而易见的,既然每条边都要经过一次,那么对于欧拉路,除了起点和终点以外,每个点如果进入了一次,一定要出去一次,显然是偶点。对于欧拉回路,每个点进入和出去的次数一定是相等的,显然没有奇点。
根据一笔画的两个定理,如果寻找欧拉回路,对任意一个点执行深度优先遍历,找欧拉路,则对一个奇点执行深度优先搜索,时间复杂度为O(m+n),m为边数,n是点数。
例题4.3 右图给出了一个加权无向图,从顶点V0开始用prim算法求最小生成树,则依次加入最小生成树的顶点集合的顶点序列是(A)。
A.V0,V1,V2,V3,V5,V4
B.V0,V1,V5,V4,V3,V3
C.V1,V2,V3,V0,V5,V4
D.V1,V2,V3,V0,V4,V5
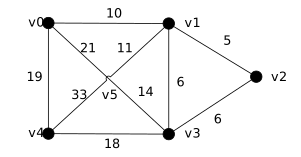
分析:prim算法是指每次找的是未选定集合中与当前集合距离最短的结点的扩展。
| 已选定点的集合 | 未选定的集合 | 连边距离最短 |
| (v0) | (v1,v4,v5) | v0v1连边距离最10 |
| (v0,v1) | (v2,v3,v4,v5) | v1v2连边距离为5 |
| (v0,v1,v2) | (v3,v4,v5) | v2v3连边距离为6 |
| (v0,v1,v2,v3) | (v4,v5) | v1v5连边距离为11 |
| (v0,v1,v2,v3,v5) | (v4) | v3v4连边距离为18 |
| (v0,v1,v2,v3,v5,v4) |